Gedächtnis für KI-Agenten mit Redis: Nutzerpräferenzen speichern

Mit Redis können KI-Agenten Kontext zwischen Modellaufrufen speichern und erneut laden, wenn derselbe Nutzer zurückkehrt. Das Modell erhält diesen Kontext mit der nächsten Anfrage. Redis speichert die Daten; Ihre Anwendung entscheidet, welche Informationen sie behält, abruft und löscht.
In dieser Anleitung merkt sich ein kleiner Python-Assistent, dass Alice vegetarische Mahlzeiten bevorzugt. Wir stoppen einen Python-Prozess, starten einen anderen mit einer neuen Sitzungs-ID und bitten ihn, ihre Präferenz abzurufen. Bob erhält ein separates Profil. Ein Vergessen-Befehl entfernt Alices aktive Redis-Einträge.
Sie können das Beispiel lokal ausführen und denselben Code dann mit Managed Redis in Lizard verbinden. Es verwendet Standard-Redis-Hash- und Listen-Befehle, sodass diese Anleitung keinen Vektorindex, RedisJSON oder ein Agenten-Framework benötigt.
Getestet am 25. September 2026: Python 3.12.10, Redis 8.8.0, redis-py==5.2.1 und vier Live-Aufrufe an openai/gpt-4.1-mini über OpenRouter. Alle 16 Prüfungen waren erfolgreich. Der Test umfasste separate Anwendungsprozesse und Sitzungen auf einer lokalen Redis-Instanz. Er umfasste keine gehostete Instanz, gleichzeitige Anfragen oder die Wiederherstellung nach einem Redis-Absturz.
Was sollte sich ein KI-Agent merken?
Beginnen Sie mit zwei Arten von Daten. Sie benötigen unterschiedliche Schlüssel und Aufbewahrungsregeln.
| Speicher | Was er enthält | Redis-Typ | Aufbewahrung in diesem Beispiel |
|---|---|---|---|
| Nutzerprofil | Eine Präferenz, die der Nutzer explizit speichert | Hash | 30 Tage nach dem letzten Profil-Schreibvorgang |
| Sitzungsverlauf | Aktuelle Nutzernachrichten und Assistentenantworten | List | Die letzten 20 Nachrichten; läuft 24 Stunden nach der letzten abgeschlossenen Runde ab |
Das Profil gehört dem Nutzer, also kann eine neue Sitzung es lesen. Der Gesprächsverlauf gehört zu einem Nutzer und einer Sitzung. Das Starten einer zweiten Sitzung kopiert nicht das Transkript der ersten Sitzung.
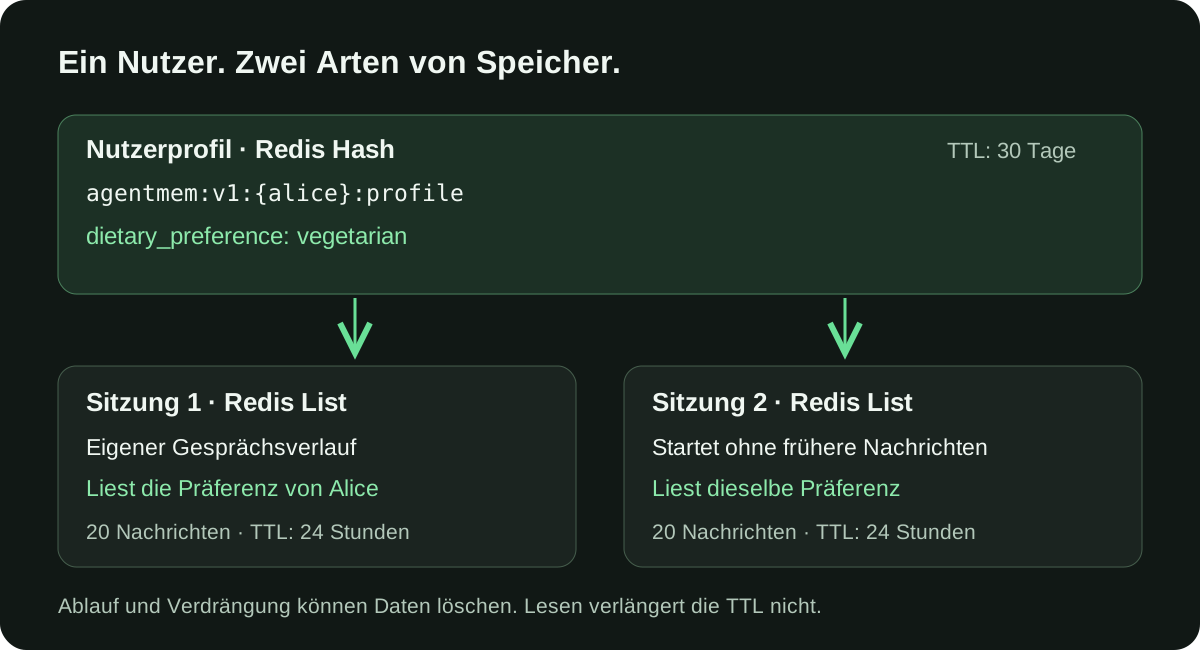
Dieser Unterschied ist wichtig, wenn der Agent antwortet: „Was weißt du über mich?“ Eine aktuelle Nachricht kann aus einer begrenzten Verlaufsliste verschwinden. Eine gespeicherte Präferenz hat ihre eigene Aufbewahrungsfrist. Beides muss nicht für immer im Kontext des Modells bleiben.
Redis bietet auch einen separaten Redis Agent Memory an. Diese Anleitung baut eine kleine Speicherschicht im Anwendungscode mithilfe einer Redis-Verbindung. Sie verwendet diesen Dienst oder seine automatischen Extraktionsfunktionen nicht.
1. Die Demo einrichten
Sie benötigen Python 3.10 oder neuer, eine Redis-Instanz nur für diesen Test und einen OpenRouter-API-Schlüssel. Verwenden Sie beim Testen erfundene Präferenzen: Das gespeicherte Profil und ausgewählte Chat-Nachrichten gehen bei jedem Aufruf an den Modellanbieter.
Laden Sie das vollständige, getestete Programm herunter und installieren Sie seine einzige Python-Abhängigkeit:
mkdir redis-memory-demo
cd redis-memory-demo
python3 -m venv .venv
. .venv/bin/activate
python -m pip install redis==5.2.1
curl -fsSLo memory_agent.py \
  https://lizard.build/blog-examples/redis-agent-memory/memory_agent.py
Führen Sie Redis für einen lokalen Test in einem separaten Terminal aus. Dieser Befehl bindet es an Loopback auf Port 6387; lassen Sie dieses Terminal laufen:
redis-server --bind 127.0.0.1 --port 6387 --save "" --appendonly noDieser lokale Redis-Prozess dient nur dem Test. Seine Daten bleiben verfügbar, wenn die Python-Anwendung beendet wird, beim Stoppen von Redis gehen diese Daten jedoch verloren. Der folgende Test startet die Anwendung neu, nicht die Datenbank.
Erstellen Sie mit Ihrem Editor eine private .env-Datei im Demo-Verzeichnis:
REDIS_URL=redis://127.0.0.1:6387/0
OPENROUTER_API_KEY=replace-with-your-key
OPENROUTER_MODEL=openai/gpt-4.1-mini
Halten Sie .env aus Git heraus. Beschränken Sie den Zugriff und laden Sie sie in die aktuelle Shell:
chmod 600 .env
set -a
. ./.env
set +a
Das Beispiel ruft die OpenRouter Chat Completions API auf. Redis verarbeitet dieselben Speicherlese- und -schreibvorgänge, wenn Sie den Modellaufruf durch einen anderen Anbieter ersetzen.
2. Jedem Nutzer und jeder Sitzung eigene Schlüssel geben
Das Programm erstellt Schlüssel wie diese:
agentmem:v1:{alice}:profile
agentmem:v1:{alice}:session:session-1
agentmem:v1:{alice}:session:session-2
agentmem:v1:{bob}:profile
Das Versionspräfix gibt zukünftigen Datenformaten einen separaten Namensraum. Die Nutzer-ID trennt Profile. Die Sitzungs-ID trennt Gespräche. Die geschweiften Klammern sind ein Redis-Hash-Tag; sie halten die Schlüssel eines Nutzers im selben Hash-Slot, falls Sie später Redis Cluster verwenden. Diese Anleitung testet eine einzelne Redis-Instanz.
Die Demo validiert IDs, bevor sie Schlüssel erstellt. In einer Webanwendung leiten Sie die Nutzer-ID aus der authentifizierten Serversitzung ab. Akzeptieren Sie nicht die ID eines anderen Nutzers aus einem Anfrage-Body und behandeln Sie sie als Identitätsnachweis. Redis-Schlüsselnamen allein erzwingen nicht, wer auf die Daten eines Nutzers zugreifen kann.
3. Eine explizite Präferenz speichern
Speichern Sie Alices Wahl:
python memory_agent.py remember --user alice --preference vegetarianDer Befehl gibt Preference saved. aus. Intern schreibt er ein Feld in einen Redis Hash und setzt den Ablauf des Profils in einer Transaktion:
with client.pipeline(transaction=True) as tx:
    tx.hset(profile, mapping={"dietary_preference": preference})
    tx.expire(profile, 30 * 24 * 60 * 60)
    tx.execute()
Die einzigen erlaubten Werte sind vegetarian, vegan und no_preference. Dieses kleine Schema macht das Beispiel leicht zu überprüfen. Das Modell kann keine beliebigen Behauptungen in das Profil schreiben. In einem echten Produkt kann eine Schaltfläche „Merken“ denselben validierten Schreibvorgang durchführen, nachdem der Nutzer ihn bestätigt hat.
Diese Anleitung leitet keine Präferenzen aus jeder Chat-Nachricht ab. Das Ändern oder Korrigieren einer Präferenz verwendet denselben expliziten Befehl, der dieses Feld überschreibt und seine 30-Tage-TTL erneuert.
4. Speicher vor dem Modellaufruf laden
Bitten Sie den Assistenten, die gespeicherte Wahl abzurufen:
python memory_agent.py chat --user alice --session session-1 \
  --message "What dietary preference have I saved?"
In unserem Test antwortete das Modell:
Your saved dietary preference is vegetarian.Bei jedem Aufruf liest die Anwendung das Profil des Nutzers und die aktuellen Nachrichten der aktuellen Sitzung. Sie baut die Modellanfrage in dieser Reihenfolge auf:
- Anweisungen, die die Aufgabe des Assistenten definieren.
- Eine Datennachricht, die die erlaubte gespeicherte Präferenz enthält.
- Die aktuellen Nutzer- und Assistentennachrichten dieser Sitzung.
- Die neue Nutzerfrage.
Das Modell hat keine direkten Redis-Anmeldedaten oder ein allgemeines Datenbank-Tool. Es erhält nur den ausgewählten Kontext. Nach einer erfolgreichen Antwort speichert die App die neuen Nutzer- und Assistentennachrichten zusammen:
with client.pipeline(transaction=True) as tx:
    tx.rpush(history, *rows)
    tx.ltrim(history, -20, -1)
    tx.expire(history, 24 * 60 * 60)
    tx.execute()
Jede Runde trägt zwei Nachrichten bei, sodass die Liste die letzten zehn vollständigen Runden behält. Die App begrenzt außerdem jede Nachricht auf 2.000 Zeichen. Eine reine Nachrichtenzählung würde die Kontextgröße nicht begrenzen, wenn eine Nachricht ein ganzes Buch enthalten könnte.
In diesem Beispiel erneuert das Lesen des Speichers nicht dessen Ablauf. Profil-Schreibvorgänge erneuern die Profil-TTL; abgeschlossene Chat-Runden erneuern die Sitzungs-TTL. Siehe die Redis EXPIRE-Referenz dafür, wie der Ablauf mit Aktualisierungen interagiert.
5. Einen neuen Prozess und eine neue Sitzung starten
Jeder CLI-Befehl startet und beendet seinen eigenen Python-Prozess. Führen Sie einen zweiten Chat-Befehl mit einer anderen Sitzungs-ID aus:
python memory_agent.py chat --user alice --session session-2 \
  --message "What dietary preference have I saved?"
Das Modell gab erneut Your saved dietary preference is vegetarian. zurück. Die neue Sitzung begann ohne die Nachrichten des ersten Gesprächs. Ihre Anfrage enthielt das geteilte Nutzerprofil, was zur Beantwortung ausreichte.
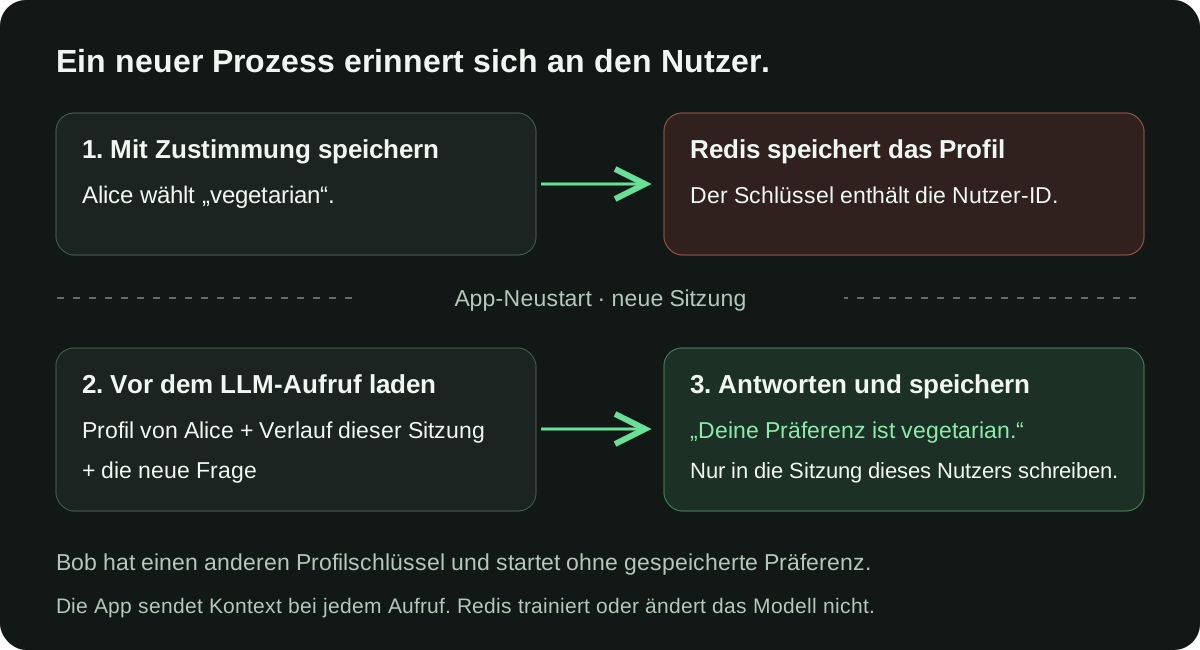
Überprüfen Sie die Datensätze, die die Anwendung liest:
python memory_agent.py inspect --user alice --session session-2Sie sollten ein Profil mit dietary_preference und einen Verlauf mit der Nutzerfrage und Assistentenantwort dieser Sitzung sehen. Dieser Ablauf ändert die Modellgewichte nicht und gibt dem Modell kein dauerhaftes internes Gedächtnis. Die Anwendung liefert den gespeicherten Kontext bei jeder Anfrage.
6. Trennung der Nutzerdaten und Vergessen prüfen
Überprüfen Sie zunächst den Kontext eines anderen Nutzers:
python memory_agent.py inspect --user bob --session session-1Für ein frisches Bob-Profil ist das Ergebnis:
{
  "profile": {},
  "history": []
}
Bobs Assistenten dieselbe Präferenzfrage zu stellen, ergab in unserem Test Your dietary preference is unknown.. Der leere Kontext ist die deterministische Isolationsprüfung; die Formulierung des Modells kann variieren.
Stoppen Sie als Nächstes alle Anfragen für Alice und entfernen Sie ihren aktiven Redis-Speicher:
python memory_agent.py forget-user --user alice
python memory_agent.py inspect --user alice --session session-1
python memory_agent.py inspect --user alice --session session-2
Beide Überprüfungen sollten leere Profile und Verläufe zurückgeben. Der Befehl sucht nur unter Alices geprüftem Schlüsselpräfix und entfernt passende Schlüssel aus Redis. Er lässt Bobs Schlüssel in Ruhe.
Blockieren Sie bei einer bereitgestellten App neue Schreibvorgänge für diesen Nutzer, während die Löschung läuft. Andernfalls könnte eine Antwort, die während des Scans endet, eine Sitzung neu erstellen. Das Löschen von Redis-Schlüsseln löscht auch keine Anbieterprotokolle, Backups oder Datensätze in einer anderen Datenbank; diese Speicher benötigen ihre eigenen Aufbewahrungs- und Löschregeln.
Was wir getestet haben
Das Verifizierungsskript startet einen neuen Redis-Prozess auf einem verfügbaren Loopback-Port. Es verbindet sich nie mit einer bestehenden Datenbank. Seine gespeicherten Ergebnisse protokollieren die Versionen, den Umfang und vier Modellantworten.
| Prüfung | Ergebnis |
|---|---|
| Eine gespeicherte Präferenz überlebt separate Python-Prozesse | Bestanden |
| Eine neue Sitzung lädt das Profil ohne das alte Transkript | Bestanden |
| Ein anderer Nutzer startet mit einem leeren Kontext | Bestanden |
| Abgelaufene Profil- und Sitzungsschlüssel verschwinden | Bestanden |
| Der Verlauf bleibt innerhalb von 20 Nachrichten und bewahrt vollständige Runden | Bestanden |
| Das Vergessen entfernt beide Sitzungen und das Profil, während ein anderer Nutzer intakt bleibt | Bestanden |
| Live-Modellaufrufe rufen die Präferenz vor der Löschung ab und melden sie danach als unbekannt | Bestanden |
Das Test-Framework führte insgesamt 16 Prüfungen durch. Diese Ergebnisse zeigen, dass die Lese- und Schreibvorgänge des Beispiels wie beschrieben funktionieren. Sie stellen keine Garantie für Produktionsverfügbarkeit oder Datenwiederherstellung dar.
Das Beispiel mit Managed Redis verbinden
Erstellen Sie nach dem lokalen Test eine separate Redis-Instanz für Ihr Projekt. Führen Sie in einem verknüpften Lizard-Projekt Folgendes aus:
lizard add redisSetzen Sie für einen bereitgestellten Dienst namens api die Verbindungsreferenz und stellen Sie ihn neu bereit:
lizard secrets set REDIS_URL='${{redis.REDIS_URL}}' --service api
lizard redeploy --service api
Diese Befehle setzen voraus, dass der Dienst bereits existiert und sein Modell-API-Schlüssel konfiguriert ist. Sie verbinden diesen Dienst mit Redis; die CLI-Demo selbst ist kein HTTP-Server. Folgen Sie der Managed Redis-Verbindungsanleitung für Umgebungsvariablen und den Zugriff von Ihrem Computer aus.
Sie können die Schlüssel der Demo im Redis-Browser im Dashboard überprüfen. Bewahren Sie Redis-Anmeldedaten auf dem Server auf und verwenden Sie eine private Verbindung oder verifiziertes TLS, wenn Ihr Anbieter dies anbietet. Eine einfache redis://-URL fügt keine Transportverschlüsselung hinzu.
Entscheiden, welche Erinnerungen Datenverlust überleben müssen
Dass Speicher einen Anwendungsneustart überlebt, bedeutet nicht, dass er jeden Redis-Ausfall überlebt. Ablauf, Verdrängung von Schlüsseln (Eviction), Persistenzeinstellungen und Backups spielen alle eine Rolle.
Managed Redis dokumentiert derzeit eine allkeys-lru-Verdrängungsrichtlinie: Speicherdruck kann jeden Schlüssel entfernen, einschließlich eines Profils, dessen TTL noch nicht abgelaufen ist. Für Präferenzen, die Sie nicht verlieren dürfen, bewahren Sie den Quelldatensatz in Managed Postgres auf und verwenden Sie Redis für aktuellen Kontext oder eine neu ladbare Kopie. Lesen Sie die Speicher- und Wiederherstellungsanleitung, bevor Sie eine Aufbewahrungsrichtlinie wählen.
Bevor Sie dies hinter eine Web-API stellen
Die CLI hält das Beispiel klein. Eine geteilte Anwendung benötigt außerdem:
- Authentifizierungs- und Prüfungen der Nutzerzuordnung. Leiten Sie Nutzer-IDs auf dem Server ab und prüfen Sie, ob jede Sitzung diesem Nutzer gehört.
- Eine aktive Runde pro Sitzung. Stellen Sie die vollständige Sequenz aus Lesen → Modellaufruf → Schreiben in eine Warteschlange oder sperren Sie sie. Die abschließende Redis-Transaktion allein verhindert nicht, dass zwei Modellaufrufe denselben alten Kontext lesen.
- Ein Speichergrößenbudget. Begrenzen Sie Profilfelder, Nachrichtengröße, Verlaufslänge und die Anzahl der Sitzungen. Überwachen Sie den Redis-Speicher und Verdrängungen.
- Eine Redis-Ausfallrichtlinie. Lassen Sie die Anfrage klar fehlschlagen oder bieten Sie einen explizit zustandslosen Modus an. Behaupten Sie niemals, eine Präferenz sei gespeichert worden, wenn der Schreibvorgang fehlgeschlagen ist.
- Berechtigungen getrennt von gespeichertem Text prüfen. Eine gespeicherte Nachricht kann feindselige Anweisungen enthalten. Behalten Sie Berechtigungen und Werkzeugentscheidungen im Anwendungscode; ein System-Prompt ist keine Zugriffskontrollgrenze.
Häufige Fragen
Brauche ich eine Vektordatenbank für das Gedächtnis eines KI-Agenten?
Sie können die expliziten Präferenzen und aktuellen Nachrichten eines bekannten Nutzers per Schlüssel laden, wie es dieses Beispiel tut. Die Vektorsuche wird nützlich, wenn die Anwendung relevante Fakten in einer viel größeren Menge von Erinnerungen finden muss. Das fügt Embeddings, Indexkonfiguration und Abruftests hinzu.
Kann ein Agent mit Redis Informationen für immer behalten?
Die Aufbewahrung hängt von TTLs, Verdrängung, Persistenz und den Schreibvorgängen Ihrer Anwendung ab. Dieses Beispiel lässt Daten absichtlich ablaufen. Bewahren Sie dauerhafte Datensätze woanders auf, wenn deren Verlust das Produkt beschädigen würde.
Ist das RAG oder ein semantischer Cache?
Dieses Beispiel ruft den gespeicherten Kontext eines Nutzers ab. RAG ruft üblicherweise relevantes Quellmaterial ab, um bei der Beantwortung einer Frage zu helfen. Ein semantischer Cache verwendet eine frühere Antwort für eine ähnliche Abfrage wieder. Sie können sich die Redis-Infrastruktur teilen, benötigen aber unterschiedliche Datenmodelle und Tests.
Kann ich später LangGraph verwenden?
Ja. LangGraph bietet Checkpoints für den Gesprächsstatus und Speicher für Erinnerungen über Threads hinweg. Seine Redis-Integration hat eigene Anforderungen; prüfen Sie die LangGraph Redis-Paketdokumentation, bevor Sie diesen einfachen Client durch ein Framework-Backend ersetzen.
Geben Sie Ihrem Agenten ein überprüfbares Gedächtnis
Beginnen Sie mit einer ausdrücklich gespeicherten Information, einem eigenen Sitzungsverlauf und einem Test, der die Daten in einem neuen Prozess abruft. Fügen Sie Ablauf, Prüfungen der Nutzerzuordnung und eine Möglichkeit zum Vergessen hinzu, bevor Sie automatische Extraktion oder Vektorsuche hinzufügen.
Erstellen Sie Managed Redis für den geteilten Kontext der Anwendung. Wenn Ihr Agent auch strukturierte Projektdaten abfragen muss, behandelt die Postgres MCP-Anleitung diese Verbindung mit einer separaten Datenbank-Leserolle.
Mit KI entwickeln. Mit Lizard ausliefern.
Du brauchst kein Plattform-Team, um live zu gehen. Deine ganze Cloud ist nur einen CLI-Befehl entfernt.
- Workspaces
- —
- Dienste
- —
- Add-ons
- —
- Bereitstellungen
- —