Redis के साथ AI एजेंट मेमोरी: अलग-अलग सेशन में यूज़र्स को याद रखें

Redis के साथ AI एजेंट मेमोरी की मदद से आपका एप्लिकेशन मॉडल कॉल्स के बीच कॉन्टेक्स्ट सेव कर सकता है और वही यूज़र लौटने पर उसे लोड कर सकता है। मॉडल को यह कॉन्टेक्स्ट अपनी अगली रिक्वेस्ट में दिखता है। डेटा Redis में रहता है; क्या रखना है, क्या वापस लाना है और क्या भूलना है, यह आपका एप्लिकेशन तय करता है।
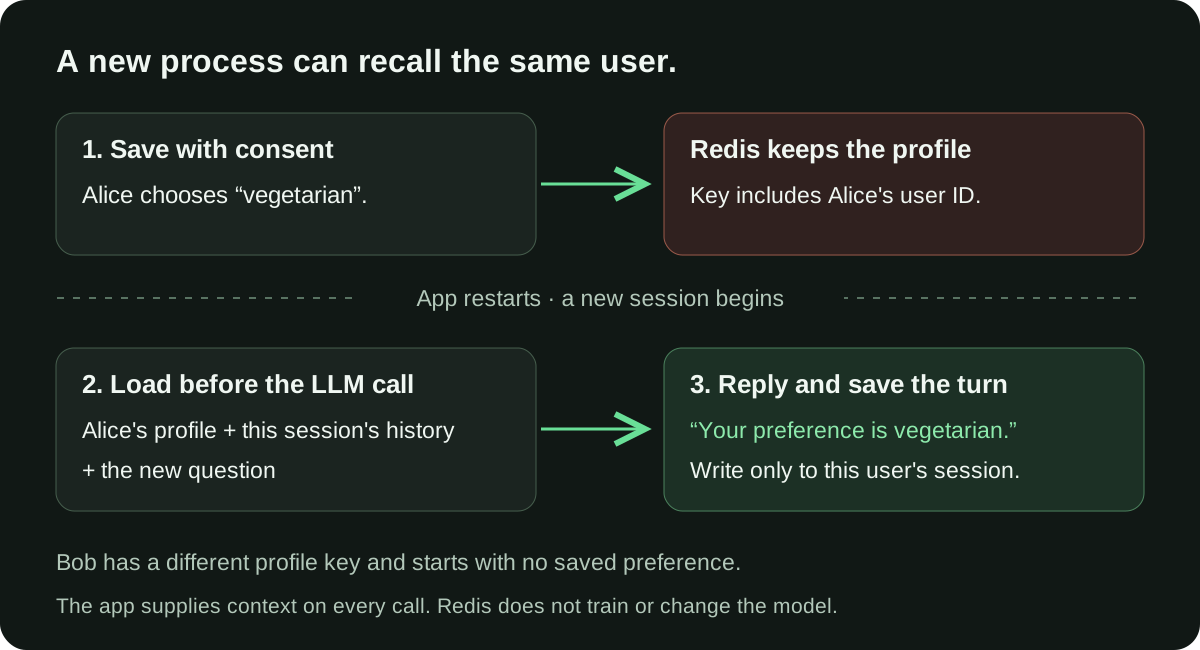
इस गाइड में एक छोटा Python असिस्टेंट याद रखता है कि Alice को शाकाहारी खाना पसंद है। हम एक Python प्रोसेस बंद करते हैं, नई सेशन ID के साथ दूसरा प्रोसेस शुरू करते हैं और उससे Alice की पसंद याद करने को कहते हैं। Bob की प्रोफ़ाइल अलग रहती है। एक forget कमांड Alice के लाइव Redis रिकॉर्ड हटा देती है।
आप उदाहरण को लोकल रूप से चला सकते हैं, फिर उसी कोड को Lizard में Managed Redis से जोड़ सकते हैं। यह स्टैंडर्ड Redis Hash और List कमांड इस्तेमाल करता है, इसलिए इस वॉकथ्रू के लिए किसी वेक्टर इंडेक्स, RedisJSON या एजेंट फ़्रेमवर्क की ज़रूरत नहीं है।
25 सितंबर 2026 को टेस्ट किया गया: Python 3.12.10, Redis 8.8.0, redis-py==5.2.1 और OpenRouter के ज़रिए openai/gpt-4.1-mini को चार लाइव कॉल। सभी 16 जांच पास हुईं। टेस्ट में एक लोकल Redis इंस्टेंस पर अलग-अलग एप्लिकेशन प्रोसेस और सेशन शामिल थे। इसमें होस्टेड इंस्टेंस, एक साथ आने वाली रिक्वेस्ट्स या Redis क्रैश के बाद रिकवरी शामिल नहीं थी।
AI एजेंट को क्या याद रखना चाहिए?
दो तरह के डेटा से शुरू करें। दोनों के लिए अलग कीज़ और रखने (retention) के अलग नियम चाहिए।
| मेमोरी | इसमें क्या है | Redis टाइप | इस उदाहरण में कितने समय तक रहती है |
|---|---|---|---|
| यूज़र प्रोफ़ाइल | वह पसंद जिसे यूज़र साफ़ तौर पर सेव करता है | Hash | प्रोफ़ाइल में आखिरी राइट के 30 दिन बाद तक |
| सेशन हिस्ट्री | यूज़र के हाल के मैसेज और असिस्टेंट के जवाब | List | आखिरी 20 मैसेज; आखिरी पूरे टर्न के 24 घंटे बाद एक्सपायर |
प्रोफ़ाइल यूज़र की होती है, इसलिए नया सेशन उसे पढ़ सकता है। बातचीत की हिस्ट्री एक यूज़र और एक सेशन की होती है। दूसरा सेशन शुरू करने पर पहले सेशन का ट्रांसक्रिप्ट उसमें कॉपी नहीं होता।
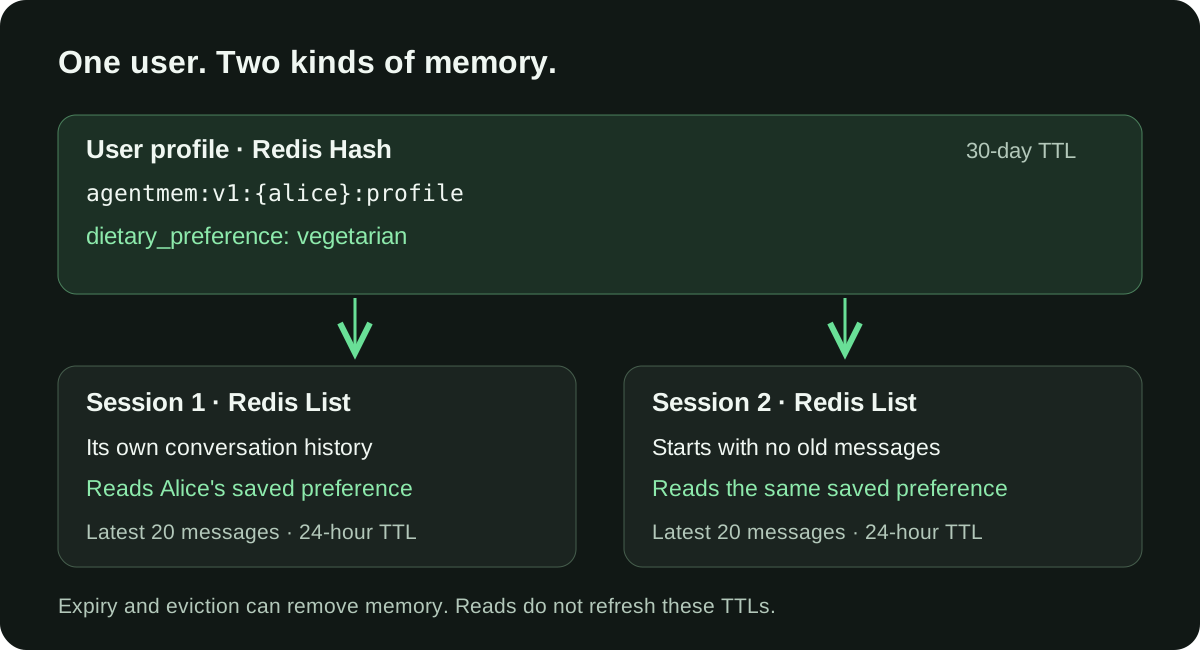
यह अंतर तब मायने रखता है जब एजेंट "आप मेरे बारे में क्या जानते हैं?" का जवाब देता है। हाल का कोई मैसेज सीमित हिस्ट्री लिस्ट से गायब हो सकता है। सेव की गई पसंद की अपनी रिटेंशन अवधि होती है। दोनों में से किसी को भी हमेशा मॉडल के कॉन्टेक्स्ट में रहने की ज़रूरत नहीं है।
Redis एक अलग Redis Agent Memory सर्विस भी देता है। यह ट्यूटोरियल Redis कनेक्शन की मदद से एप्लिकेशन कोड में एक छोटी मेमोरी लेयर बनाता है। यह न उस सर्विस का इस्तेमाल करता है, न उसके ऑटोमैटिक एक्सट्रैक्शन फ़ीचर्स का।
1. डेमो सेट अप करें
आपको Python 3.10 या उसके बाद का वर्ज़न, एक डिस्पोज़ेबल Redis इंस्टेंस और OpenRouter API की चाहिए। टेस्ट करते समय नकली (काल्पनिक) पसंद इस्तेमाल करें: सेव की गई प्रोफ़ाइल और चुने गए चैट मैसेज हर कॉल पर मॉडल प्रोवाइडर के पास जाते हैं।
पूरा, टेस्ट किया हुआ प्रोग्राम डाउनलोड करें और उसकी एक Python डिपेंडेंसी इंस्टॉल करें:
mkdir redis-memory-demo
cd redis-memory-demo
python3 -m venv .venv
. .venv/bin/activate
python -m pip install redis==5.2.1
curl -fsSLo memory_agent.py \
  https://lizard.build/blog-examples/redis-agent-memory/memory_agent.py
लोकल टेस्ट के लिए Redis को एक अलग टर्मिनल में चलाएँ। यह कमांड इसे loopback पर पोर्ट 6387 से बाइंड करती है; वह टर्मिनल चलता रहने दें:
redis-server --bind 127.0.0.1 --port 6387 --save "" --appendonly noयह लोकल Redis प्रोसेस जानबूझकर डिस्पोज़ेबल रखा गया है। Python एप्लिकेशन बंद होने पर भी इसका डेटा बना रहता है, लेकिन Redis रोकते ही वह डेटा खो जाता है। नीचे का टेस्ट एप्लिकेशन को रीस्टार्ट करता है, डेटाबेस को नहीं।
अपने एडिटर से डेमो डायरेक्टरी में एक प्राइवेट .env फ़ाइल बनाएँ:
REDIS_URL=redis://127.0.0.1:6387/0
OPENROUTER_API_KEY=replace-with-your-key
OPENROUTER_MODEL=openai/gpt-4.1-mini
.env को Git से बाहर रखें। उसकी एक्सेस सीमित करें और उसे मौजूदा शेल में लोड करें:
chmod 600 .env
set -a
. ./.env
set +a
उदाहरण OpenRouter Chat Completions API को कॉल करता है। अगर आप मॉडल कॉल को किसी दूसरे प्रोवाइडर से बदलते हैं, तब भी Redis मेमोरी के वही रीड और राइट संभालता है।
2. हर यूज़र और सेशन को उसकी अपनी कीज़ दें
प्रोग्राम इस तरह की कीज़ बनाता है:
agentmem:v1:{alice}:profile
agentmem:v1:{alice}:session:session-1
agentmem:v1:{alice}:session:session-2
agentmem:v1:{bob}:profile
वर्ज़न प्रीफ़िक्स भविष्य के डेटा फ़ॉर्मैट के लिए अलग नेमस्पेस देता है। यूज़र ID प्रोफ़ाइल्स को अलग करती है। सेशन ID बातचीत को अलग करती है। ब्रेसेज़ Redis hash tag हैं; अगर आप बाद में Redis Cluster इस्तेमाल करते हैं, तो ये एक यूज़र की सभी कीज़ को एक ही hash slot में रखते हैं। यह गाइड एक ही Redis इंस्टेंस पर टेस्ट की गई है।
डेमो कीज़ बनाने से पहले ID को वैलिडेट करता है। वेब एप्लिकेशन में यूज़र ID को ऑथेंटिकेटेड सर्वर सेशन से लें। किसी दूसरे यूज़र की ID को रिक्वेस्ट बॉडी से लेकर उसे पहचान का सबूत न मानें। सिर्फ़ Redis की के नाम से यह तय नहीं होता कि यूज़र के डेटा तक कौन पहुंच सकता है।
3. साफ़ तौर पर बताई गई पसंद सेव करें
Alice की पसंद सेव करें:
python memory_agent.py remember --user alice --preference vegetarianकमांड Preference saved. प्रिंट करती है। अंदर यह एक Redis Hash में एक फ़ील्ड लिखती है और उसी ट्रांज़ैक्शन में प्रोफ़ाइल की एक्सपायरी सेट करती है:
with client.pipeline(transaction=True) as tx:
    tx.hset(profile, mapping={"dietary_preference": preference})
    tx.expire(profile, 30 * 24 * 60 * 60)
    tx.execute()
सिर्फ़ vegetarian, vegan और no_preference वैल्यू की अनुमति है। यह छोटा स्कीमा उदाहरण को जांचना आसान बनाता है। मॉडल प्रोफ़ाइल में मनमाने दावे नहीं लिख सकता। असली प्रोडक्ट में "इसे याद रखें" बटन यूज़र की पुष्टि के बाद वही वैलिडेट किया हुआ राइट कर सकता है।
यह गाइड हर चैट मैसेज से पसंद का अंदाज़ा नहीं लगाती। पसंद बदलने या सुधारने के लिए वही साफ़ कमांड इस्तेमाल होती है, जो उस फ़ील्ड को ओवरराइट करती है और उसका 30 दिन का TTL फिर से शुरू कर देती है।
4. मॉडल को कॉल करने से पहले मेमोरी लोड करें
असिस्टेंट से सेव की गई पसंद याद करने को कहें:
python memory_agent.py chat --user alice --session session-1 \
  --message "What dietary preference have I saved?"
हमारे टेस्ट में मॉडल ने यह जवाब दिया:
Your saved dietary preference is vegetarian.हर कॉल के लिए एप्लिकेशन यूज़र की प्रोफ़ाइल और मौजूदा सेशन के हाल के मैसेज पढ़ता है। वह मॉडल रिक्वेस्ट इस क्रम में बनाता है:
- असिस्टेंट का काम तय करने वाले निर्देश।
- एक डेटा मैसेज, जिसमें अनुमति वाली सेव की गई पसंद होती है।
- इस सेशन के यूज़र और असिस्टेंट के हाल के मैसेज।
- यूज़र का नया सवाल।
मॉडल के पास न तो सीधे Redis क्रेडेंशियल हैं, न कोई सामान्य डेटाबेस टूल। उसे सिर्फ़ चुना गया कॉन्टेक्स्ट मिलता है। सफल जवाब के बाद ऐप यूज़र और असिस्टेंट के नए मैसेज एक साथ स्टोर करता है:
with client.pipeline(transaction=True) as tx:
    tx.rpush(history, *rows)
    tx.ltrim(history, -20, -1)
    tx.expire(history, 24 * 60 * 60)
    tx.execute()
हर टर्न में दो मैसेज जुड़ते हैं, इसलिए लिस्ट में आखिरी दस पूरे टर्न रहते हैं। ऐप हर मैसेज को 2,000 कैरेक्टर तक सीमित भी करता है। अगर एक ही मैसेज में पूरी किताब आ सकती हो, तो सिर्फ़ मैसेज गिनने से कॉन्टेक्स्ट का साइज़ सीमित नहीं होगा।
इस उदाहरण में मेमोरी पढ़ने से उसकी एक्सपायरी आगे नहीं बढ़ती। प्रोफ़ाइल में राइट होने पर प्रोफ़ाइल का TTL फिर से शुरू होता है; पूरे हुए चैट टर्न सेशन का TTL फिर से शुरू करते हैं। अपडेट के साथ एक्सपायरी कैसे काम करती है, यह Redis EXPIRE रेफ़रेंस में देखें।
5. नया प्रोसेस और नया सेशन शुरू करें
हर CLI कमांड अपना अलग Python प्रोसेस शुरू करती है और काम पूरा होने पर उससे बाहर निकल जाती है। अलग सेशन ID के साथ दूसरी चैट कमांड चलाएँ:
python memory_agent.py chat --user alice --session session-2 \
  --message "What dietary preference have I saved?"
मॉडल ने फिर से Your saved dietary preference is vegetarian. लौटाया। नया सेशन पहली बातचीत के मैसेज के बिना शुरू हुआ। उसकी रिक्वेस्ट में शेयर की गई यूज़र प्रोफ़ाइल थी, जो जवाब देने के लिए काफ़ी थी।
वे रिकॉर्ड देखें जिन्हें एप्लिकेशन पढ़ता है:
python memory_agent.py inspect --user alice --session session-2आपको dietary_preference वाली प्रोफ़ाइल और उस सेशन के यूज़र के सवाल और असिस्टेंट के जवाब वाली हिस्ट्री दिखनी चाहिए। मॉडल के weights में कुछ नया नहीं जुड़ा है और न ही उसे कोई स्थायी अंदरूनी मेमोरी मिली है। एप्लिकेशन हर रिक्वेस्ट पर स्टोर किया गया कॉन्टेक्स्ट देता है।
6. यूज़र आइसोलेशन और forget की जांच करें
पहले किसी दूसरे यूज़र का कॉन्टेक्स्ट देखें:
python memory_agent.py inspect --user bob --session session-1Bob की नई प्रोफ़ाइल के लिए नतीजा यह है:
{
  "profile": {},
  "history": []
}
हमारे टेस्ट में Bob के असिस्टेंट से पसंद वाला वही सवाल पूछने पर Your dietary preference is unknown. मिला। खाली कॉन्टेक्स्ट ही भरोसेमंद (deterministic) आइसोलेशन जांच है; मॉडल के शब्द अलग हो सकते हैं।
इसके बाद, Alice के लिए आने वाली सभी रिक्वेस्ट्स रोकें और उसकी लाइव Redis मेमोरी हटाएँ:
python memory_agent.py forget-user --user alice
python memory_agent.py inspect --user alice --session session-1
python memory_agent.py inspect --user alice --session session-2
दोनों जांच में खाली प्रोफ़ाइल और खाली हिस्ट्री दिखनी चाहिए। कमांड सिर्फ़ Alice के वैलिडेट किए गए की प्रीफ़िक्स को स्कैन करती है और मेल खाने वाली कीज़ को unlink करती है। Bob की कीज़ को यह नहीं छूती।
डिप्लॉय किए गए ऐप में, डिलीशन चलने तक उस यूज़र के नए राइट्स ब्लॉक करें। वरना स्कैन के दौरान पूरा होने वाला कोई जवाब सेशन को फिर से बना सकता है। Redis कीज़ हटाने से प्रोवाइडर के लॉग, बैकअप या किसी दूसरे डेटाबेस के रिकॉर्ड नहीं हटते; उन स्टोर्स के लिए रिटेंशन और डिलीशन के अपने नियम चाहिए।
हमने क्या टेस्ट किया
वेरिफ़िकेशन स्क्रिप्ट किसी उपलब्ध loopback पोर्ट पर नया Redis प्रोसेस शुरू करती है। यह कभी किसी मौजूदा डेटाबेस से कनेक्ट नहीं होती। इसके सेव किए गए नतीजे वर्ज़न, दायरा और मॉडल के चार जवाब दर्ज करते हैं।
| जांच | नतीजा |
|---|---|
| सेव की गई पसंद अलग-अलग Python प्रोसेस के बाद भी बनी रहती है | पास |
| नया सेशन पुराने ट्रांसक्रिप्ट के बिना प्रोफ़ाइल लोड करता है | पास |
| दूसरा यूज़र खाली कॉन्टेक्स्ट से शुरू करता है | पास |
| एक्सपायर हुई प्रोफ़ाइल और सेशन कीज़ गायब हो जाती हैं | पास |
| हिस्ट्री 20 मैसेज के भीतर रहती है और पूरे टर्न बचाकर रखती है | पास |
| forget से दोनों सेशन और प्रोफ़ाइल हट जाते हैं, दूसरा यूज़र जस का तस रहता है | पास |
| लाइव मॉडल कॉल हटाने से पहले पसंद याद रखते हैं और बाद में उसे अज्ञात बताते हैं | पास |
टेस्ट हार्नेस ने कुल 16 जांच चलाईं। ये नतीजे दिखाते हैं कि उदाहरण के रीड और राइट बताए गए तरीके से काम करते हैं। इनसे प्रोडक्शन अवेलेबिलिटी या डेटा रिकवरी की कोई गारंटी साबित नहीं होती।
उदाहरण को Managed Redis से कनेक्ट करें
लोकल टेस्ट के बाद अपने प्रोजेक्ट के लिए एक अलग Redis इंस्टेंस बनाएँ। नए अकाउंट को पहले 7 दिन का Pro ट्रायल शुरू करना होगा (कार्ड ज़रूरी है); तब तक lizard add HTTP 402 के साथ एक Checkout लिंक लौटाता है, जिसे lizard billing start खोलता है। लिंक किए गए Lizard प्रोजेक्ट में चलाएँ:
lizard add redisapi नाम की डिप्लॉय की गई सर्विस के लिए कनेक्शन रेफ़रेंस सेट करें और रीडिप्लॉय करें:
lizard secrets set REDIS_URL='${{redis.REDIS_PRIVATE_URL}}' --service api
lizard redeploy --service api
प्राइवेट URL उसी प्रोजेक्ट और रीजन की सर्विसेज़ से काम करता है; अपने कंप्यूटर से REDIS_URL इस्तेमाल करें। ये कमांड मानकर चलती हैं कि सर्विस पहले से मौजूद है और उसकी मॉडल API की कॉन्फ़िगर है। ये उस सर्विस को Redis से जोड़ती हैं; CLI डेमो खुद कोई HTTP सर्वर नहीं है। एनवायरनमेंट वेरिएबल और अपने कंप्यूटर से एक्सेस के लिए Managed Redis कनेक्शन गाइड फ़ॉलो करें।
डेमो की कीज़ आप डैशबोर्ड के Redis ब्राउज़र में देख सकते हैं। Redis क्रेडेंशियल सर्वर पर ही रखें, और अगर आपका प्रोवाइडर देता है तो प्राइवेट कनेक्शन या वेरिफ़ाइड TLS इस्तेमाल करें। सादा redis:// URL ट्रांसपोर्ट एन्क्रिप्शन नहीं देता।
तय करें कि कौन-सी मेमोरी डेटा खोने के बाद भी बचनी चाहिए
ऐप रीस्टार्ट के बाद मेमोरी बचे रहने का मतलब यह नहीं कि वह Redis की हर गड़बड़ी के बाद भी बची रहेगी। एक्सपायरी, key eviction, पर्सिस्टेंस सेटिंग्स और बैकअप, सब मायने रखते हैं।
Managed Redis में न कोई eviction policy सेट है, न append-only file (AOF)। यह Redis के डिफ़ॉल्ट पीरियॉडिक स्नैपशॉट के ज़रिए डेटा को पर्सिस्टेंट वॉल्यूम पर रखता है। अगर इंस्टेंस की मेमोरी खत्म हो जाती है, तो वह रीस्टार्ट होता है और आखिरी स्नैपशॉट के बाद हुए राइट्स खो सकते हैं। जिन पसंदों को आप खोने का जोखिम नहीं ले सकते, उनका मूल रिकॉर्ड Managed Postgres में रखें और Redis को हाल के कॉन्टेक्स्ट या दोबारा लोड की जा सकने वाली कॉपी के लिए इस्तेमाल करें। रिटेंशन नीति चुनने से पहले स्टोरेज और रिकवरी गाइड देखें।
इसे वेब API के पीछे रखने से पहले
CLI उदाहरण को छोटा रखता है। शेयर किए जाने वाले एप्लिकेशन को इनकी भी ज़रूरत होती है:
- ऑथेंटिकेशन और ओनरशिप जांच। यूज़र ID सर्वर पर तय करें और जांचें कि हर सेशन उसी यूज़र का है।
- हर सेशन में एक समय पर एक ही टर्न। पूरे क्रम (रीड → मॉडल कॉल → राइट) को क्यू में डालें या लॉक करें। सिर्फ़ आखिरी Redis ट्रांज़ैक्शन से दो मॉडल कॉल्स को एक ही पुराना कॉन्टेक्स्ट पढ़ने से नहीं रोका जा सकता।
- मेमोरी साइज़ का बजट। प्रोफ़ाइल फ़ील्ड, मैसेज साइज़, हिस्ट्री की लंबाई और सेशन की संख्या सीमित करें। Redis मेमोरी और evictions पर नज़र रखें।
- Redis फ़ेल होने की नीति। रिक्वेस्ट को साफ़ तौर पर फ़ेल करें या स्पष्ट रूप से stateless मोड दें। अगर राइट फ़ेल हुआ है, तो कभी यह दावा न करें कि पसंद सेव हो गई।
- याद किए गए टेक्स्ट को अधिकारों से अलग रखें। सेव किए गए मैसेज में नुकसानदेह (malicious) निर्देश हो सकते हैं। परमिशन और टूल से जुड़े फ़ैसले एप्लिकेशन कोड में रखें; सिस्टम प्रॉम्प्ट एक्सेस कंट्रोल की सीमा नहीं है।
आम सवाल
क्या AI एजेंट मेमोरी के लिए मुझे वेक्टर डेटाबेस चाहिए?
जैसा यह उदाहरण करता है, आप किसी जाने-पहचाने यूज़र की साफ़ तौर पर बताई गई पसंद और हाल के मैसेज की से लोड कर सकते हैं। वेक्टर सर्च तब काम आती है जब एप्लिकेशन को बहुत बड़ी मेमोरी में से काम के तथ्य ढूंढने हों। इसके लिए embeddings, इंडेक्स कॉन्फ़िगरेशन और retrieval टेस्ट जोड़ने पड़ते हैं।
क्या Redis से एजेंट हमेशा के लिए याद रखता है?
रिटेंशन TTL, eviction, पर्सिस्टेंस और आपके एप्लिकेशन के राइट्स पर निर्भर करता है। यह उदाहरण जानबूझकर डेटा को एक्सपायर होने देता है। जिन रिकॉर्ड्स के खोने से प्रोडक्ट टूट जाएगा, उन्हें किसी टिकाऊ (durable) स्टोर में अलग रखें।
क्या यह RAG है या एक सिमेंटिक कैश?
यह उदाहरण एक यूज़र का सेव किया गया कॉन्टेक्स्ट वापस लाता है। RAG आम तौर पर किसी सवाल का जवाब देने के लिए काम का सोर्स मटीरियल ढूंढकर लाता है। सिमेंटिक कैश मिलती-जुलती क्वेरी के लिए पहले के जवाब को दोबारा इस्तेमाल करता है। ये एक ही Redis इंफ्रास्ट्रक्चर शेयर कर सकते हैं, लेकिन इनके डेटा मॉडल और टेस्ट अलग होने चाहिए।
क्या मैं बाद में LangGraph का उपयोग कर सकता हूँ?
हाँ। LangGraph बातचीत की स्थिति के लिए checkpoints और अलग-अलग threads में मेमोरी के लिए stores देता है। इसके Redis इंटीग्रेशन की अपनी ज़रूरतें हैं; इस आसान क्लाइंट को फ़्रेमवर्क बैकएंड से बदलने से पहले LangGraph Redis पैकेज डॉक्यूमेंटेशन देखें।
अपने एजेंट को ऐसी मेमोरी दें जिसे आप जांच सकें
एक साफ़ तथ्य, एक अलग सेशन हिस्ट्री और एक ऐसे टेस्ट से शुरू करें जो प्रोसेस की सीमा पार करता हो। ऑटोमैटिक एक्सट्रैक्शन या वेक्टर सर्च जोड़ने से पहले एक्सपायरी, ओनरशिप जांच और forget का तरीका जोड़ें।
एप्लिकेशन के शेयर किए गए कॉन्टेक्स्ट के लिए Managed Redis बनाएँ। अगर आपके एजेंट को स्ट्रक्चर्ड प्रोजेक्ट डेटा पर क्वेरी भी करनी है, तो Postgres MCP गाइड अलग डेटाबेस रीडर भूमिका के साथ वह कनेक्शन समझाती है।
AI के साथ बिल्ड करें। Lizard के साथ शिप करें।
लाइव जाने के लिए आपको प्लेटफ़ॉर्म टीम की ज़रूरत नहीं है। आपका पूरा क्लाउड, बस एक CLI कमांड की दूरी पर।
- सर्विसेज़
- —
- ऐडऑन
- —
- डिप्लॉयमेंट्स
- —
- सैंडबॉक्स स्टार्ट्स
- —